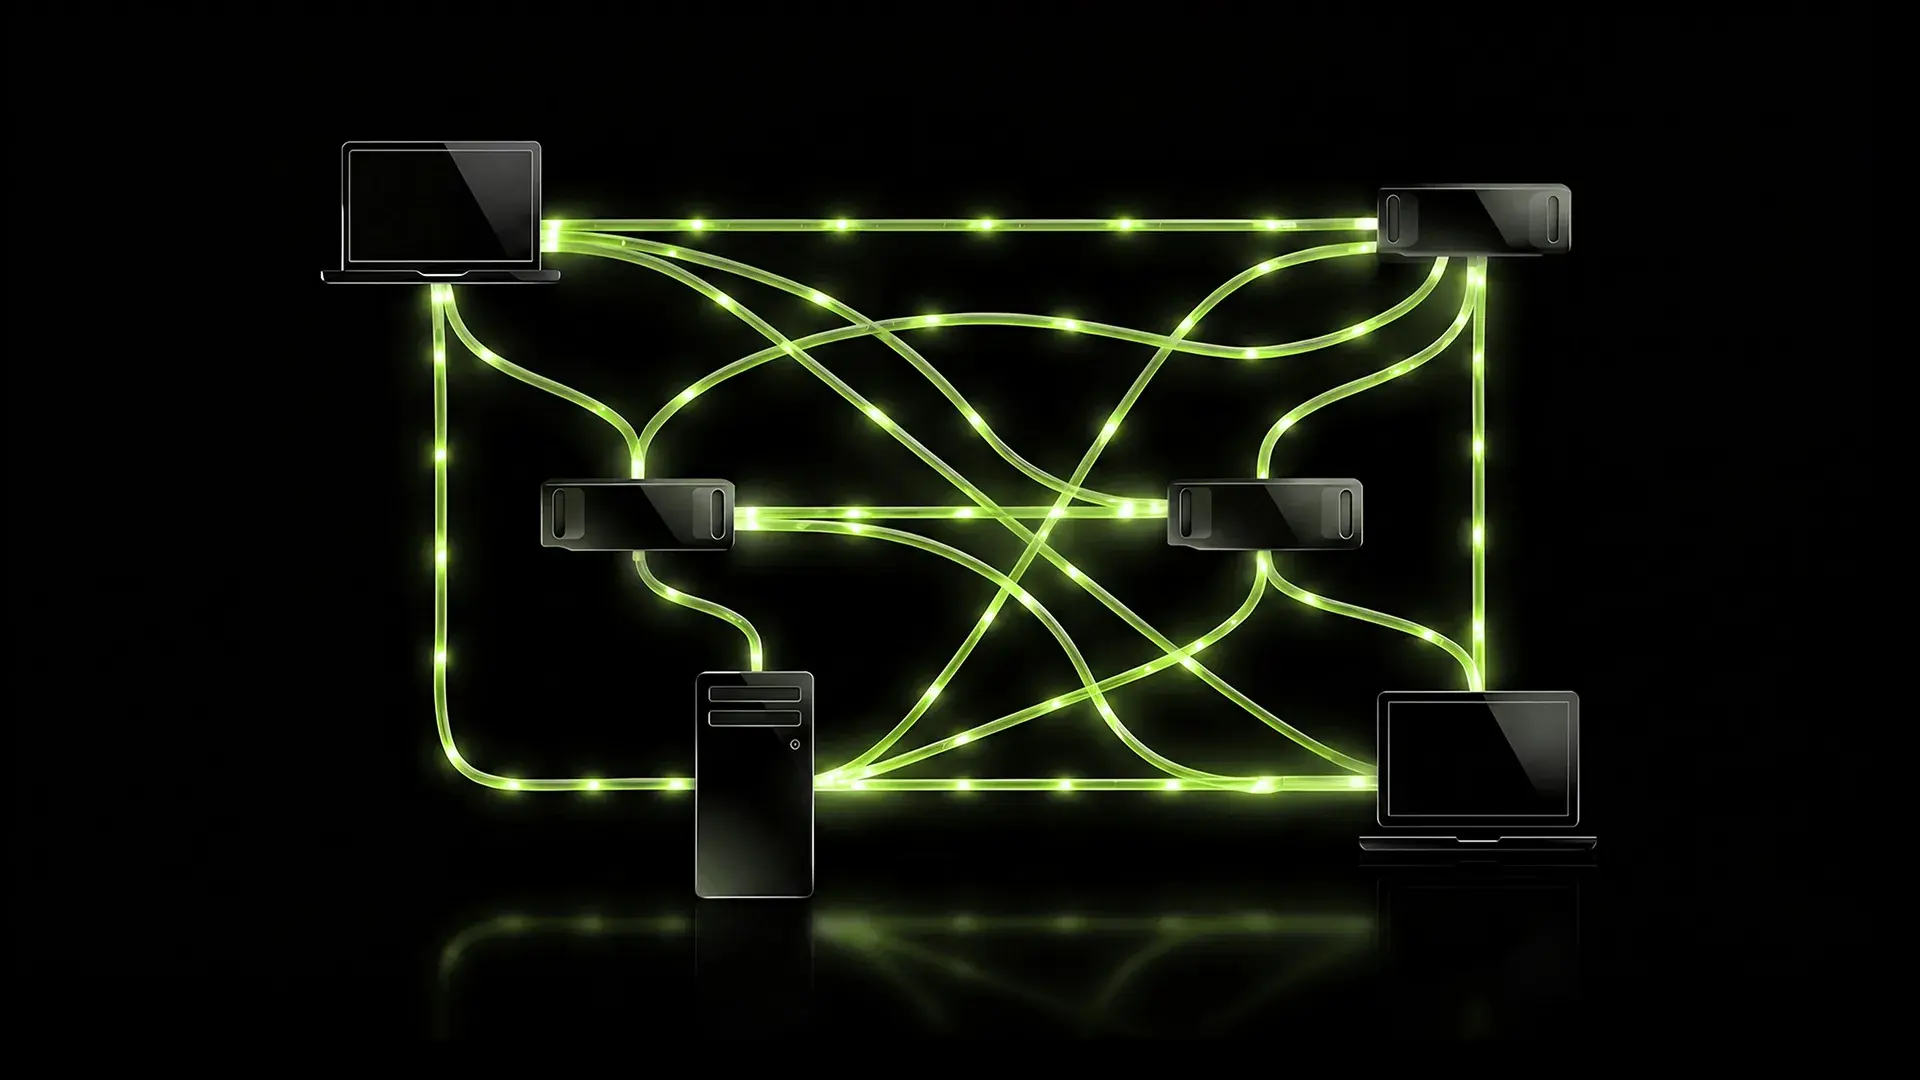
在2026年IFA展會上,NVIDIA發布了一項將重新定義本地人工智慧的解決方案。此方案名為個人AI路由器(簡稱PAIR),旨在利用現有家用電腦協同執行AI任務。它並非實體路由器或新的推理引擎,而是一個充當AI應用與本地網路中各種設備之間橋樑的工具。
其理念很簡單:如果你擁有一台遊戲電腦、工作站,甚至是配備現代晶片的MacBook,那麼很可能它的大部分運算能力每天都會閒置數小時。 PAIR能夠偵測這些設備,將它們安全連接起來,並將AI代理產生的推理請求分配給這些設備,從而確保工作負載不會因單一顯示卡而超負荷運轉。
NVIDIA PAIR究竟是什麼?
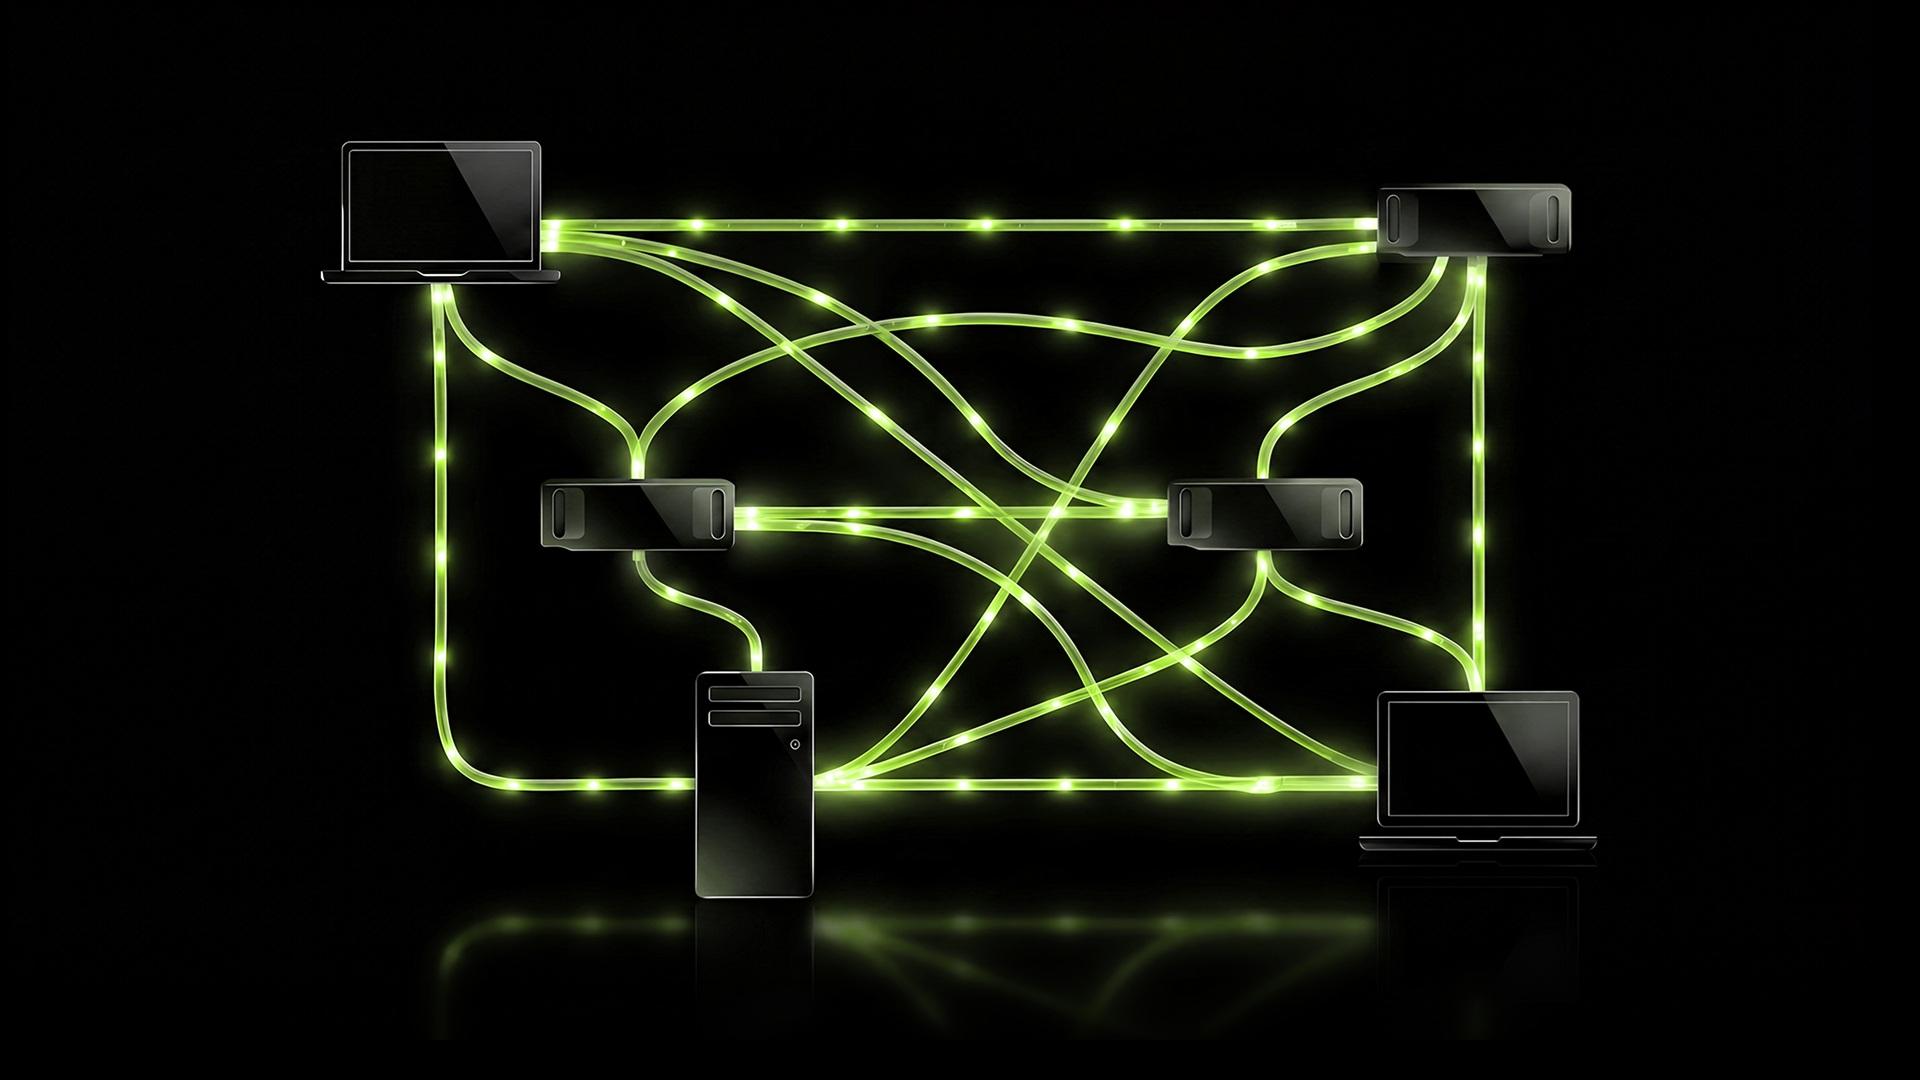
PAIR 是一款免費開源軟體,它充當 AI 應用和安裝在每台機器上的推理引擎之間的代理。當一個代理程式同時啟動多個子任務時,PAIR 會根據機器是否載入了所需的模型、目前的 GPU 負載以及機器是否可用,來決定網路中哪台機器可以處理每個子任務。對於使用者而言,整個過程無縫銜接:他們只會看到一個連接,而後台流量則在各個參與節點之間自動分配。
PAIR 的一個關鍵特性在於它並非取代 Ollama 或 LM Studio,而是充分利用它們。實際上,PAIR 會接管這些引擎預設用於接收請求的端口,並將請求轉發到最合適的節點。這意味著現有應用程式無需任何更改即可繼續運行,從而顯著降低了那些已在本地建立 AI 環境的用戶的入門門檻。
任務劃分是如何運作的
設備發現是透過mDNS 協定實現的,該協定與印表機用於在網路上顯示自身資訊的協定相同。安裝完成後,每台設備都會廣播自身的可用性,其他設備會自動偵測到它。您也可以直接使用 IP 位址新增節點,但通常的做法是,主裝置會顯示一個六位數的 PIN 碼,其他裝置必須輸入該 PIN 碼才能建立配對。
連線成功後,節點間的通訊將使用mTLS 加密,這表示雙方使用憑證來確保流量不會離開私有網路。這對於處理敏感資訊的用戶至關重要,因為代理指令和資料都保留在本地,無需經過任何外部伺服器。然而,專案開發者提醒,在共享網路或不受信任的網路上使用該專案之前,應仔細檢查其區域網路安全性,因為它會開放本地 HTTP 端點,並允許在區域網路內進行發現。
表演和演示
最關鍵的問題是,它是否真的能提升效能。 NVIDIA 分享了一個非官方演示,演示中使用了 Hermes Desktop 代理和 Ollama,運行在 Qwen 3.6 35B A3B 型號的顯示卡上。在一台 RTX Spark 筆記型電腦上平均需要 18 分鐘才能完成的包含五個子代理的任務,在由三台機器組成的集群(筆記型電腦、DGX Spark 和 RTX 5090)上僅用了 8 分 48 秒就完成了。這種超過兩倍的效能提升,是因為子任務可以在多個 GPU 上並行執行,而不是像以前那樣在單一 GPU 上排隊等待。
該公司強調,這既不是通用的基準測試,也不代表線性擴展。結果很大程度上取決於工作負載類型、所用模型、網路配置以及可用節點。對於高度順序執行的任務,或只有一台機器具備所需模型的任務,效能提升有限。此外,PAIR 不會共享不同顯示卡的內存,因此它並非用於載入單個 GPU 無法承載的模型的解決方案。
兼容性和要求
PAIR 測試版適用於Windows 11、Linux 和 macOS,支援 x64 和 arm64 架構(儘管 Windows on ARM 仍處於實驗階段)。硬體需求包括 GeForce RTX 20 系列或更新的 GPU、基於 Turing 架構的 RTX PRO 或更新的 GPU、DGX Spark 或 Apple M4 或更新的晶片。此外,至少需要 8 GB 記憶體和 20 GB 磁碟空間。運行 PAIR 無需網路連接,僅在下載模板時需要連接互聯網。
一個有趣的細節是,PAIR 並不局限於 NVIDIA 產品;任何能夠運行 Ollama 或 LM Studio 的電腦都可以參與,包括搭載 Apple Silicon 的系統。事實上,它已在最多 18 個 GPU 的網路上成功測試過。節點可以靈活地隨時加入和退出——例如,當筆記型電腦進入睡眠狀態或 PC 開始玩遊戲時——這是它的另一個顯著特點,因為調度器會即時調整節點分佈。
RTX Spark 和其他新功能
PAIR的發布正值NVIDIA即將推出首批搭載RTX Spark顯示卡的PC之際,該PC計畫於10月上市。這些機器將Blackwell GPU與20核心Grace CPU以及高達128GB的統一記憶體結合,旨在本地運行AI代理。在IFA展會上,聯想(Yoga Pro 9n和Yoga 9n)和宏碁(一款緊湊型桌上型電腦概念產品)展示了各自的產品,而戴爾、惠普、華碩、微星和微軟預計也將發佈各自的產品。
除了 PAIR 之外,NVIDIA 也宣布簡化其他代理專案的使用。 Perplexity Portable Computer 將支援 Windows 和 Linux 系統上至少配備 24 GB 顯存的 RTX GPU,使用戶無需花費積分即可運行完整的工作流程,並且只需事先獲得將資料傳送到雲端的許可。 Hermes Agent 將整合一鍵式設置,自動偵測 GPU,OpenClaw 也將在 Windows 系統上提供類似選項。
在效能方面,llama.cpp 中的最佳化使GeForce RTX 5090 的吞吐量提升高達 1,9 倍,而 vLLM 使 Blackwell RTX PRO 6000 的吞吐量提升 1,2 倍,在兩張 DGX Spark 顯示卡組成的叢集上提升高達 1,4 倍。這些改進已透過 LM Studio、Ollama 和引擎本身提供。
所有這些都指向一個清晰的趨勢:將大部分人工智慧工作從雲端轉移到我們現有的家用硬體上。 PAIR 是實現這一目標的另一個重要組成部分,雖然它目前仍處於測試階段,但如果您擁有不止一台高性能計算機,那麼它值得一試。最終版本尚未確定發布日期,但社群成員現在即可透過 GitHub 下載並貢獻改進方案。